БАР текстовый анализатор от Максима Котёнкова 👇
БАР против ГАР (Релевантус): нейросети отменили текстовый анализ или просто переупаковали его?
Последнее время я всё чаще вижу противопоставление «старых» текстовых анализаторов и новых нейросетевых инструментов. В качестве примера особенно интересно сравнить БАР и ГАР (Релевантус): первый делает акцент на ИИ, сущностях и семантической близости, второй — на измеримых характеристиках страницы относительно конкурентов из ТОПа.
Почему меня заинтересовало сравнение БАР и ГАР
Автор БАР довольно активно критикует классические текстовые анализаторы. В публичных материалах ГАР (Релевантус), Миратекст, SEO Lemma и похожие решения противопоставляются более современному подходу через нейросети, сущности, NER, SBERT и косинусную близость.
При этом на закрытом созвоне SEO HEAD я специально задал вопрос о подготовке текстов. Ответ был интересным: классический анализатор для написания текста автор практически не использует, однако показал собственный инструмент, который тоже изучает документы конкурентов и извлекает из них тематические признаки.
То есть сам принцип «посмотреть на ТОП и достать из него полезные признаки» никуда не исчез.
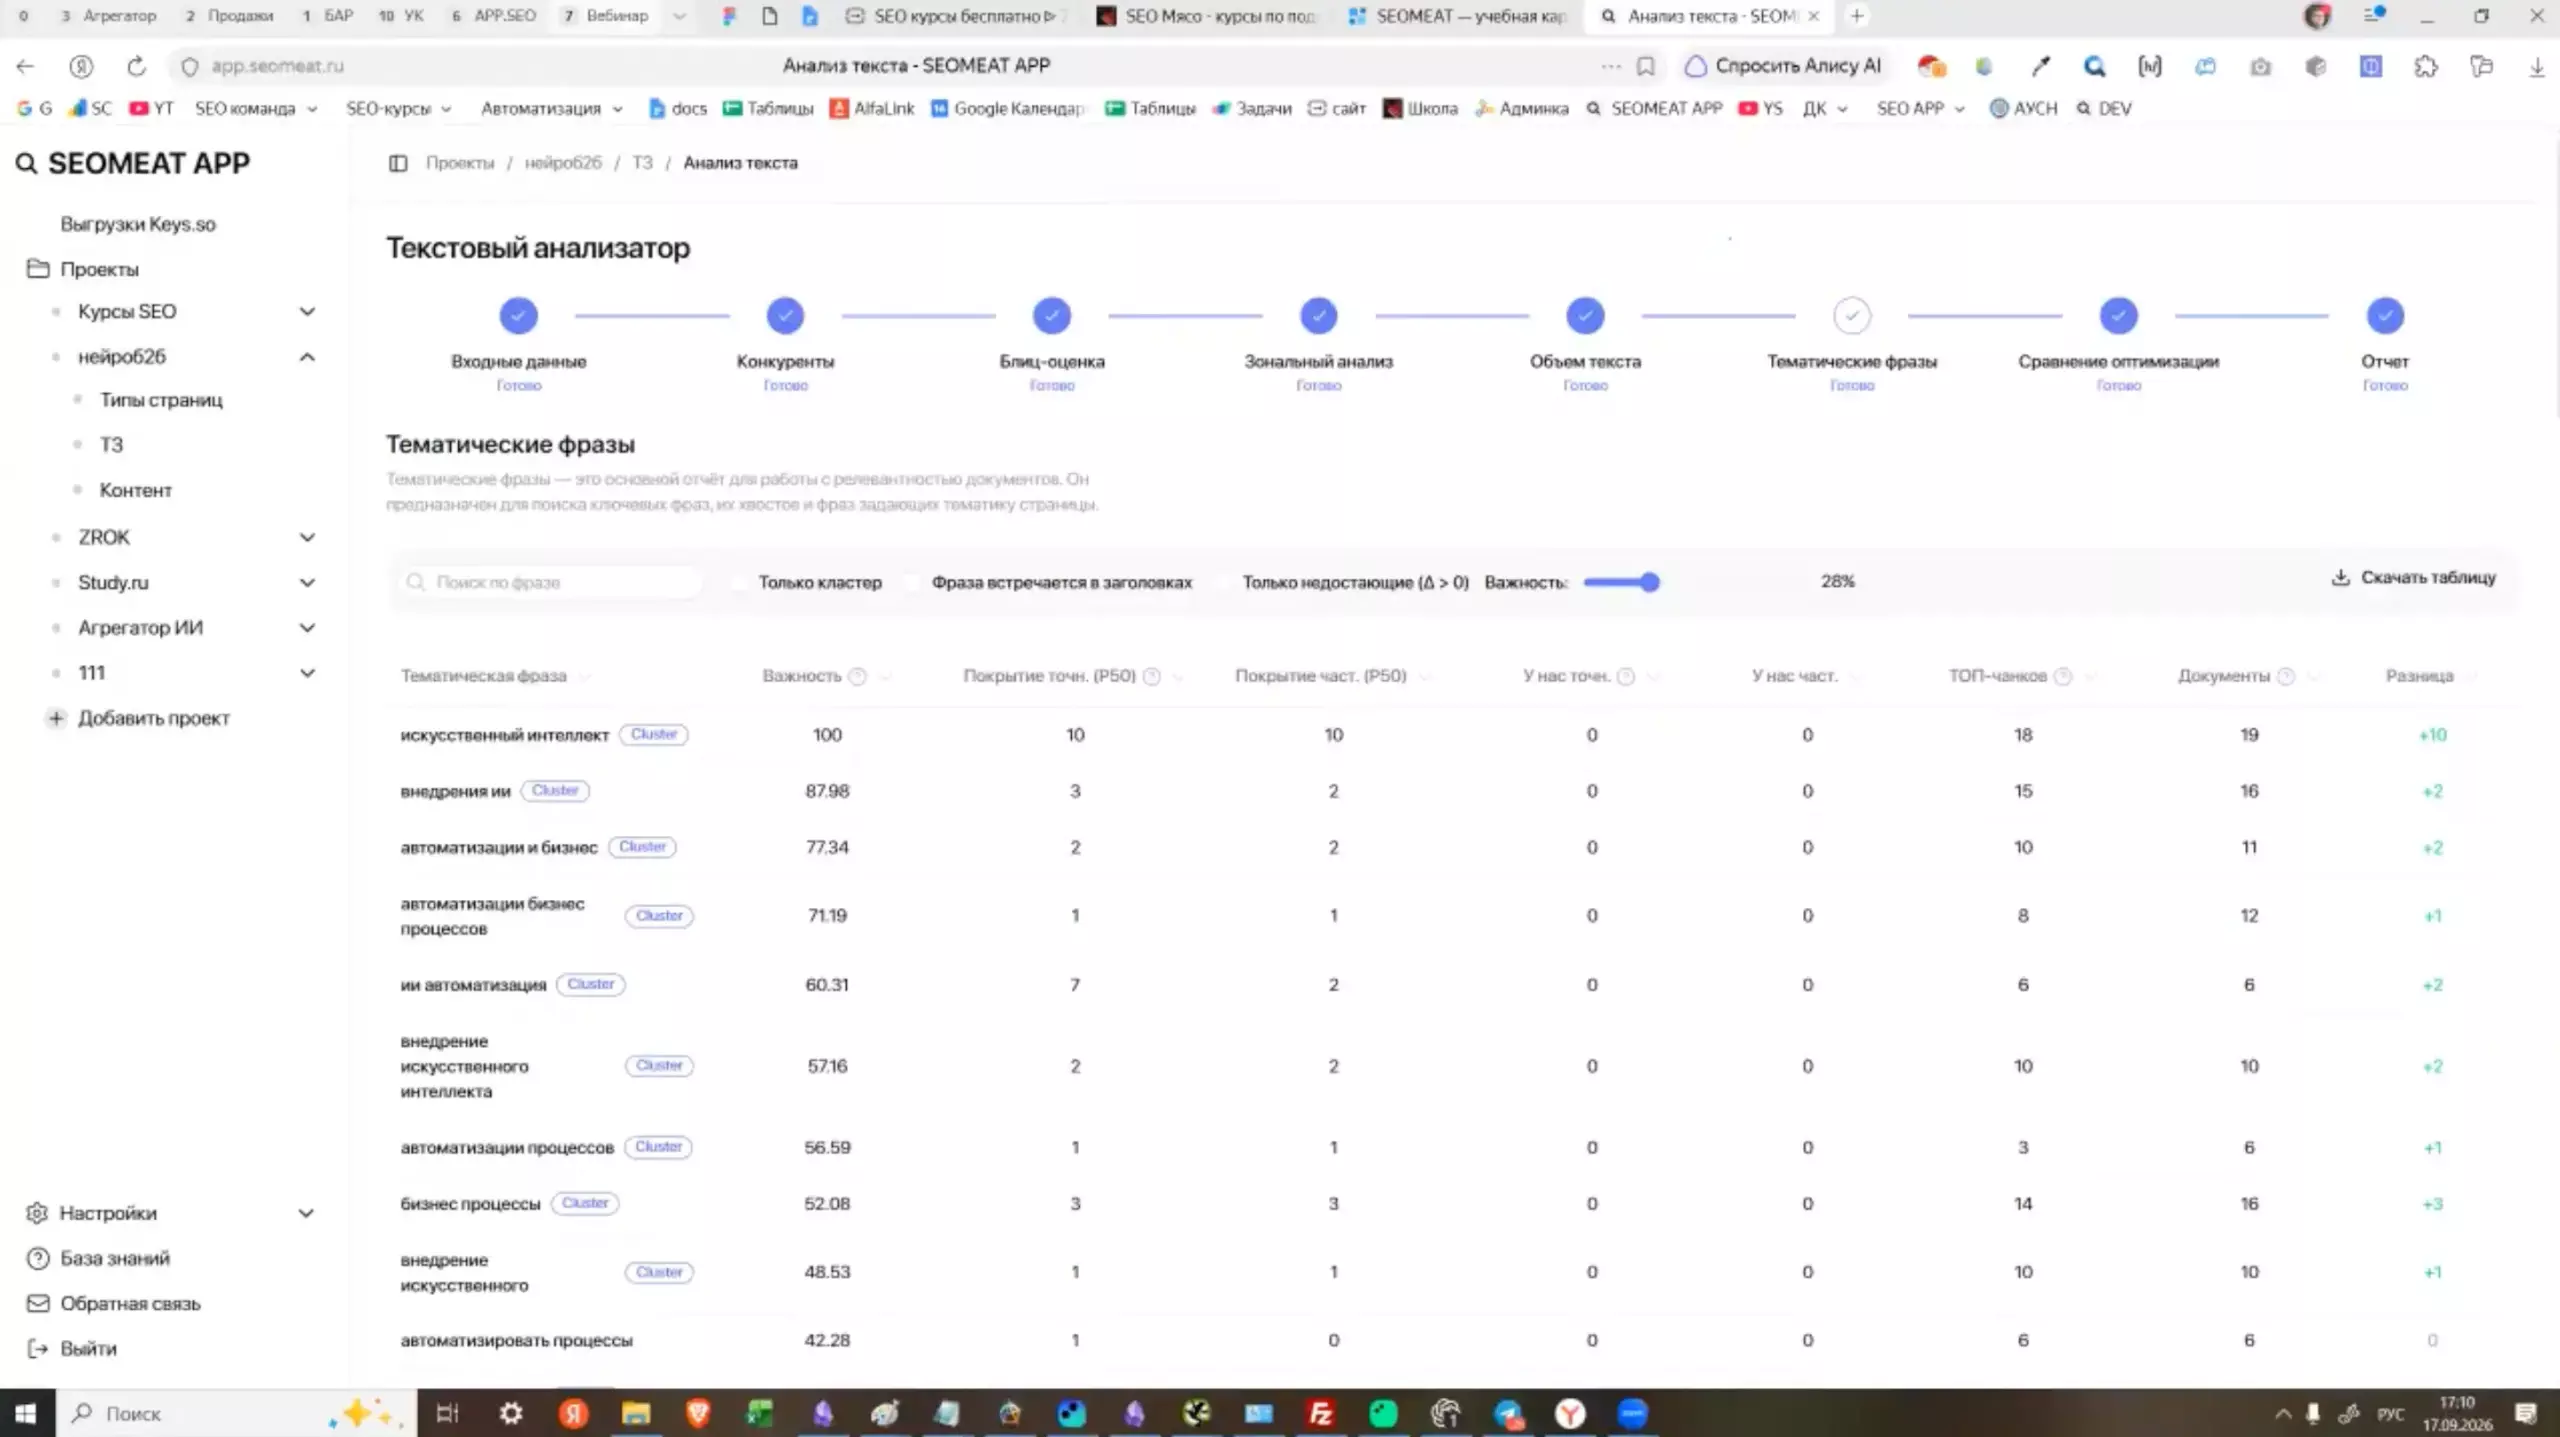
Изменился способ фильтрации этих признаков.
Что автор БАР критикует в классическом подходе
Основная претензия понятна. Классический анализ может перебирать отдельные слова, биграммы и другие n-граммы, из-за чего специалист получает много комбинаций без самостоятельного смысла.
БАР предлагает другой путь: нейросеть читает документы, выделяет осмысленные тематические фразы и оценивает их связь с основной темой. Для этого используются методы извлечения сущностей и семантического сравнения.
В такой постановке я вообще не вижу проблемы. ИИ действительно может оказаться удобнее простого перебора всех сочетаний слов.
Проблема начинается в момент, когда из преимущества одного способа фильтрации делается более широкий вывод: будто частоты, n-граммы, плотность, повторы и другие классические измерения документа больше не нужны.
Что на самом деле делает БАР с текстами конкурентов
Если убрать модные названия моделей, логика БАР выглядит достаточно знакомо.
- Инструмент получает документы конкурентов из поисковой выдачи.
- Нейросеть извлекает из текстов тематически значимые слова и фразы.
- Модель пытается отделить осмысленные признаки темы от случайных сочетаний.
- Семантическая близость помогает расположить найденные элементы по предполагаемой важности.
- Специалист использует полученный набор при создании или корректировке страницы.
Это хороший алгоритм.
Но сама задача знакома любому человеку, который когда-либо делал текстовый анализ конкурентов: найти в ТОПе признаки, отсутствующие на своей странице.
Главное противоречие: анализ ТОПа всё равно остаётся
Особенно интересно сопоставить критику классических методов с более поздними рассуждениями самого автора БАР о том, почему анализ конкурентов работает.
Логика там примерно такая:
- K — ключевые слова;
- E — остальные полезные признаки и тематические элементы, закрывающие интент;
- G — мусор, который случайно присутствует у конкурентов.
Все эти элементы вместе образуют условный массив M признаков ТОПа.
И вот здесь я практически полностью согласен.
Если бездумно вставить весь массив M, страница действительно получит ключи и полезные тематические признаки, но одновременно наберёт огромное количество мусора.
Поэтому реальная задача анализатора — не просто найти слова у конкурентов, а максимально точно отделить K и E от G.
Но обратите внимание: исходным источником сигнала всё равно остаются документы конкурентов.
То есть проблема не в самом текстовом анализе. Проблема в качестве определения значимости найденных признаков.
БАР и ГАР решают разные части одной задачи
И вот здесь, на мой взгляд, сравнение БАР с ГАР (Релевантус) начинает ломаться.
БАР по показанным материалам прежде всего отвечает на вопрос:
Какие фразы и тематические признаки в документах конкурентов выглядят значимыми?
ГАР решает другой прикладной кусок:
Как характеристики моей страницы отличаются от документов ТОПа и что можно изменить?
Это связанные задачи, но они не идентичны.
Представим, что БАР нашёл важную фразу «автоматизация бизнес-процессов».
Отлично. Но дальше мне как SEO-специалисту хочется получить ещё несколько ответов.
- Есть ли эта фраза у меня?
- Сколько раз встречается её лемматика?
- Сколько вхождений у конкурентов?
- В каких зонах страницы она используется?
- Есть ли она в H1, H2 или только основном тексте?
- У меня недобор или перебор?
- Как меняется показатель при увеличении объёма текста?
Если инструмент отвечает только на первый вопрос, он не заменяет весь текстовый анализ. Он хорошо решает отдельный этап.
Почему сущности не заменяют частоту, зоны и повторы
Фраза «поисковые системы работают с сущностями» звучит красиво, но иногда из неё делают слишком далеко идущий вывод.
Допустим, нейросеть определила:
«внедрение искусственного интеллекта» — важная сущность страницы.
Хорошо.
Теперь рассмотрим четыре документа.
| Страница | Что происходит с термином | Что увидит простой чек сущностей |
|---|---|---|
| A | Фраза встречается 1 раз в футере | Есть |
| B | Фраза есть в H2 и раскрыта в отдельном блоке | Есть |
| C | Термин встречается 8 раз в разных тематических фрагментах | Есть |
| D | Фраза повторена 40 раз и создаёт явную аномалию | Есть |
С точки зрения бинарного признака сущность присутствует во всех четырёх документах.
С точки зрения текстовой оптимизации документы совершенно разные.
Наличие сущности не отменяет её частоту, расположение и окружение.
Косинусная близость и SBERT не делают инструмент автоматически лучше
Ещё один популярный аргумент: TF-IDF устарел, потому что поисковые системы давно используют BERT-подобные технологии, поэтому вместо старых методов нужно применять SBERT и косинусную близость.
Я сам активно использую косинусную близость. Поэтому спорить с её полезностью было бы странно.
Но косинус отвечает на конкретный вопрос:
Насколько два представления близки друг другу в выбранном векторном пространстве?
Он не отвечает автоматически на вопросы:
- сколько раз термин должен встретиться;
- в какой части документа он нужен;
- есть ли у страницы аномальный перебор;
- достаточно ли одного употребления;
- нужен термин в H2 или основном абзаце;
- почему конкурент выше именно по этому запросу.
Поэтому фраза «мы используем SBERT вместо TF-IDF» сама по себе ничего не доказывает.
В 2026 году косинусная близость вообще перестала быть какой-то уникальной фишкой. Вопрос давно сместился на уровень того, как инструмент собирает выборку, режет документ, фильтрует мусор и превращает числа в рекомендацию.
Что происходит с H1, H2, фрагментами и зонами документа
Вот этот момент мне особенно интересен.
Современный текстовый анализ давно вышел за рамки простого подсчёта слов.
Одни инструменты показывают термины по H1, H2 и H3. Другие анализируют пассажи и короткие фрагменты. Третьи разделяют верх, середину и низ текста. Некоторые отдельно смотрят таблицы, списки, ссылки и основной контент.
Поэтому к БАР у меня возникает совершенно практический вопрос.
Если сущность найдена — где именно она должна находиться?
Допустим, десять конкурентов содержат термин.
У восьми он присутствует в отдельном тематическом H2-блоке, у одного — в FAQ, ещё у одного — один раз в подвале.
Если инструмент просто сообщает «сущность встречается у десяти конкурентов», часть информации потеряна.
Если он показывает распределение по зонам — прекрасно. Но тогда БАР начинает двигаться ровно туда же, куда уже много лет движутся продвинутые текстовые анализаторы.
Почему я не списываю со счетов плотность и повторяемость
Здесь у меня с автором БАР одно из главных расхождений.
Я тоже не считаю, что существует магическое значение вроде «ключ должен занимать 3,7% текста».
Но из этого совершенно не следует, что частота употребления слов становится бесполезной.
Возьмём максимально простой пример.
Если в ТОП-10 значимый термин встречается у большинства страниц в диапазоне 5–12 употреблений, а на моей странице он встречается 0 раз, это полезная информация.
Если он встречается 60 раз — это тоже полезная информация.
Я не обязан автоматически доводить страницу до среднего значения конкурентов.
Но я хочу видеть эту аномалию.
В этом и состоит важное различие:
измерять признак — не значит слепо оптимизировать страницу под среднее значение.
Плотность сама по себе не гарантирует позиции. Частота сама по себе не гарантирует релевантность. Но обе величины описывают документ и могут выявить недобор, перекос или переспам.
K + E + G: здесь позиции внезапно становятся очень похожи
Самое забавное, что после всех споров наши позиции могут оказаться намного ближе, чем кажется.
Берём массив терминов ТОПа:
M = K + E + G.
Есть полезные ключи. Есть тематические признаки. Есть мусор.
Классический инструмент пытается оценивать их через частоту, TF-IDF, расстояние, совместную встречаемость и другие статистические методы.
БАР пытается улучшить фильтрацию через нейросеть, NER, embeddings и косинус.
Это нормальное развитие инструментов.
Но отсюда я делаю другой вывод:
нейросеть не убивает текстовый анализ — она становится ещё одним методом определения значимости признаков внутри текстового анализа.
И это, на мой взгляд, намного точнее описывает происходящее.
Что умеет БАР и чего от него пока не видно
Ниже я специально пишу «не подтверждено», а не «не умеет». Я видел не весь функционал БАР, поэтому отсутствие функции на скриншоте не означает отсутствие функции в продукте.
| Возможность | БАР по показанным материалам | Другие текстовые анализаторы |
|---|---|---|
| Анализ конкурентов | Да | Да |
| Извлечение тематических фраз | Да | Да |
| Фильтрация бессмысленных n-грамм через ИИ | Да, одна из сильных сторон | Зависит от инструмента |
| Сущности | Да | Есть во многих современных решениях |
| Косинусная близость | Да | Есть у ряда решений |
| Сравнение количественных вхождений | Не подтверждено | Часто есть |
| Недобор и перебор терминов | Не подтверждено | Есть у специализированных инструментов |
| Плотность и повторяемость | Подход критикуется | Обычно измеряется |
| Раздельный анализ H1/H2/H3 | Не подтверждено | Есть у части решений |
| Фрагменты и пассажи | Не подтверждено | Есть у ряда инструментов |
| Рекомендация «добавить/убрать» | Нужно смотреть полный функционал | Одна из основных функций ГАР и аналогов |
Поэтому пока я бы формулировал осторожно.
БАР выглядит интересным инструментом определения тематически значимых признаков.
Но утверждение, что он полностью заменяет ГАР (Релевантус), требует сравнения по функциям, а не по наличию нейросети внутри.
Причём здесь подписка за 5 000 рублей
Есть ещё одна деталь, которую нельзя полностью игнорировать.
Автор развивает собственную школу и закрытый клуб. Доступ стоит около 5 000 рублей в месяц, а подписчики получают возможность скачивать инструменты, включая БАР.
Сам факт коммерческой модели абсолютно нормален.
Я тоже делаю инструменты и прекрасно понимаю, зачем специалисту собственные продукты.
Но возникает естественный контекст: когда человек одновременно продаёт доступ к своему инструментарию и публично объясняет, почему альтернативные решения устарели или не нужны, сравнивать заявления особенно полезно на уровне конкретного функционала.
Я не утверждаю, что критика ГАР появляется ради продажи подписки. Мотив человека я знать не могу.
Но экономический интерес существует, поэтому мне гораздо интереснее не спорить о намерениях, а просто открыть два инструмента и сравнить их по одинаковым критериям.
Как бы я проверял заявление «БАР заменяет ГАР»
- Взять одинаковый список запросов и один набор конкурентов.
- Получить рекомендации БАР и ГАР (Релевантус) для одной страницы.
- Разделить рекомендации на ключи, тематические признаки и очевидный мусор.
- Посмотреть, какой инструмент лучше показывает количественные и зональные аномалии документа.
- Проверить изменения на реальных страницах, а не по внутреннему скору самого сервиса.
После такого теста уже можно предметно обсуждать замену одного инструмента другим.
Мой вывод: нейросеть улучшает отбор признаков, но не отменяет измерения
Я бы вообще не ставил вопрос как «старое SEO против нейросетей».
У каждого метода своя функция.
- NER и нейросеть
- Помогают понять, какие слова и фразы образуют осмысленные тематические объекты.
- SBERT и косинусная близость
- Показывают семантическую близость фразы или фрагмента к выбранной теме.
- Частотный анализ
- Показывает, сколько раз признак встречается в документе и насколько страница отличается от выборки.
- Зонирование
- Показывает, где находится признак: в H1, H2, основном тексте, списке, таблице или другом фрагменте.
- Анализ ТОПа
- Даёт сравнительную выборку и помогает увидеть признаки, характерные для документов, уже находящихся в выдаче.
Именно совокупность этих методов мне кажется наиболее практичной.
Нейросеть может намного лучше отфильтровать мусор. Но от этого количество, распределение и расположение найденного сигнала не перестают существовать.
Поэтому я пока не вижу смерти классического текстового анализа.
Я вижу его нормальную эволюцию: статистические признаки дополняются нейросетевыми методами.
И если завтра БАР добавит качественное зонирование, частотные аномалии, сравнение H-блоков, недобор и перебор, то он сам станет тем самым современным текстовым анализатором, от которого сегодня пытается дистанцироваться.
Вопросы про БАР, ГАР и нейрооптимизацию
- БАР бесполезен?
- Нет. Извлечение осмысленных тематических фраз через ИИ выглядит полезной функцией, особенно когда простой перебор n-грамм создаёт много мусора.
- БАР полностью заменяет ГАР (Релевантус)?
- По показанным мне материалам такой вывод пока сделать нельзя. Инструменты пересекаются в анализе конкурентов, но ГАР решает дополнительные задачи количественной корректировки документа.
- TF-IDF устарел после появления BERT?
- BERT и TF-IDF решают разные математические задачи. Современная модель может лучше оценивать семантику, но статистические признаки документа от появления embeddings не исчезают.
- Нужно ли оптимизировать плотность ключевых слов?
- Фиксированный процент сам по себе не нужен. Полезнее искать аномалии относительно документов одной выдачи и понимать причину каждого изменения.
- Сущности важнее ключевых слов?
- Такое противопоставление слишком упрощает поиск. Запрос пользователя состоит из слов, а системы могут сопоставлять их с документами через леммы, синонимы, embeddings и другие представления.
- Как понять, какой текстовый анализатор лучше?
- Сравнивайте не название алгоритма, а данные на выходе: выборку конкурентов, фильтрацию мусора, зоны документа, частоты, фрагменты и конкретность рекомендаций.
Если совсем коротко
Все статьи и новости →БАР может лучше классического перебора отделять полезные тематические фразы от мусора. Но способность нейросети найти сущность ещё не заменяет ответы на вопросы «сколько?», «где?», «у кого?», «в какой зоне?» и «что конкретно изменить?». Поэтому нейросети не отменили текстовый анализ. Они дали ему ещё один сильный слой.
