Как проверить SEO-текст, написанный ChatGPT 👇
Проверить текст от ChatGPT, или «чатгпт» в русскоязычных запросах, — значит оценить факты, интент, структуру и пользу, а не угадать автора по проценту детектора. Поисковые системы не требуют ловить нейросеть по стилю. Перед размещением важнее найти выдуманные данные, пропущенные темы и механические повторы.
По запросу о проверке текста выдача смешивает разные задачи: редактуру, поиск плагиата, распознавание ИИ и анализ страницы. Там встречаются формулировки «Как проверить материал», «написанный» и «написанную нейросетью». Есть даже совет: «проверить текст на ChatGPT бесплатно можно использовать диалоговый инструмент». Отдельно мелькает Writer. Такой набор легко уводит проверку не туда.
Что оценивать в тексте вместо происхождения
Официальное руководство советует оценивать автоматически созданный контент по точности, качеству и релевантности. Генеративная модель предсказывает последовательность токенов, поэтому уверенный тон не подтверждает факт. Ручная вычитка нужна основной части, Title, Description, разметке и подписям изображений.
Отдельная рекомендация поисковика — делать контент для людей и добавлять самостоятельную ценность. Пересказ лидеров выдачи не становится сильнее после красивой переформулировки. Нужны собственные наблюдения, понятный автор и сведения, которых нет в соседних результатах.
| Слой | Что искать | Критерий готовности |
|---|---|---|
| Интент | Задача читателя и формат публикации | Ответ виден по H1 и первым разделам |
| Факты | Даты, цифры, функции, имена и ссылки | У каждого сильного утверждения есть доказательство или личное наблюдение |
| Полнота | Вопросы, сущности и ограничения | Читателю не требуется повторный поиск ради базового ответа |
| Язык | Штампы, ровный ритм и пустые выводы | Абзацы различаются по назначению и содержат конкретные действия |
| Поиск | Мета-теги, H1–H6, внутренние ссылки | Элементы описывают содержание без механического набивания ключей |
Если хотя бы одна цифра не подтверждается ссылкой, то удалите её либо укажите, что это оценка. Читатель получит доказуемое утверждение вместо правдоподобной галлюцинации.
Эти принципы описаны в рекомендациях Google по генеративному контенту и в руководстве по people-first content. Там нет запрета на сам инструмент. Речь идёт о точности, пользе и добавленной ценности.
Что query fan-out ChatGPT добавляет к исходному запросу
Query fan-out показывает дополнительные формулировки, которые ассистент отправляет в веб-поиск. В этом эксперименте чатгпт сделал два обращения к Search Central. Оба раскрывают критерии, по которым стоит сверять результат генерации.

Google Search Central AI generated content guidance helpful content people-first content 2026Google Search Central SEO starter guide search intent content quality headings
Первая ветка ведёт к точности, качеству, релевантности и ручному фактчеку. Вторая связывает интент, понятные заголовки и помощь поисковой системе в понимании документа. Получился готовый список смыслов, а не случайная россыпь LSI-слов.
Я не считаю два обращения универсальным шаблоном: другой диалог или модель могут сформировать иную цепочку. Ценность метода в другом. Мы видим реальные подзапросы конкретного ответа и понимаем, закрывает ли страница каждую ветку.
Если важный подзапрос остался без ответа, то добавьте его в подходящий раздел. Ассистент получит цельную информацию, а читатель — объяснение без смысловой дыры.
Зачем разбирать заголовки ChatGPT по корням конкурентов
Следующий слой — H1–H6 релевантных результатов из классического поиска. Я собираю формулировки, общие основы терминов и исходные отрывки. Так видны не только тезисы, но и место каждого сюжета в архитектуре.
В моей выборке среди H2 часто встречались «вопросы», «текст», «ChatGPT», «контроль», «сервисы», «промпты» и «нейросеть». Это не команда вставить весь набор. Частотность показывает ожидания, стабильно отражаемые разными авторами.
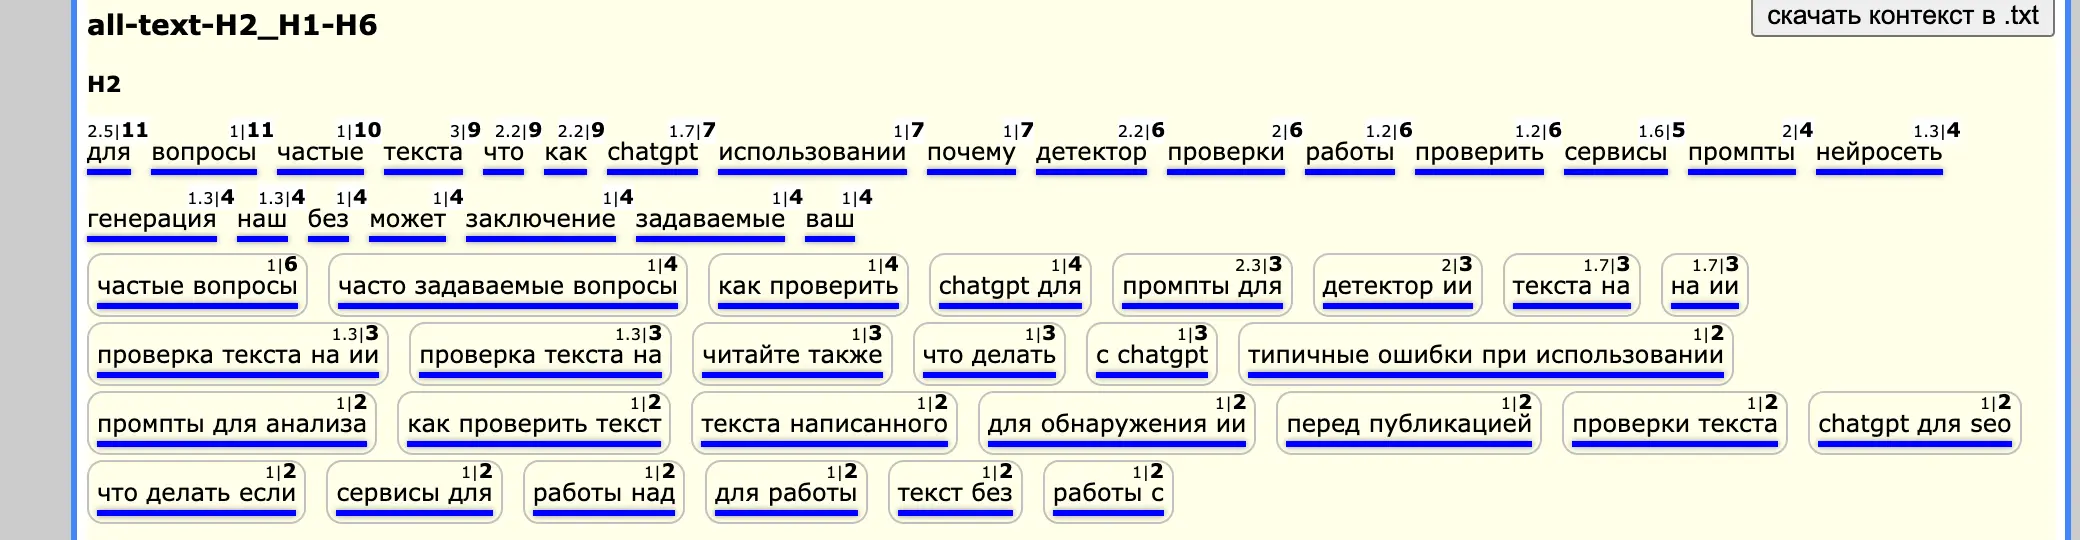
Контексты
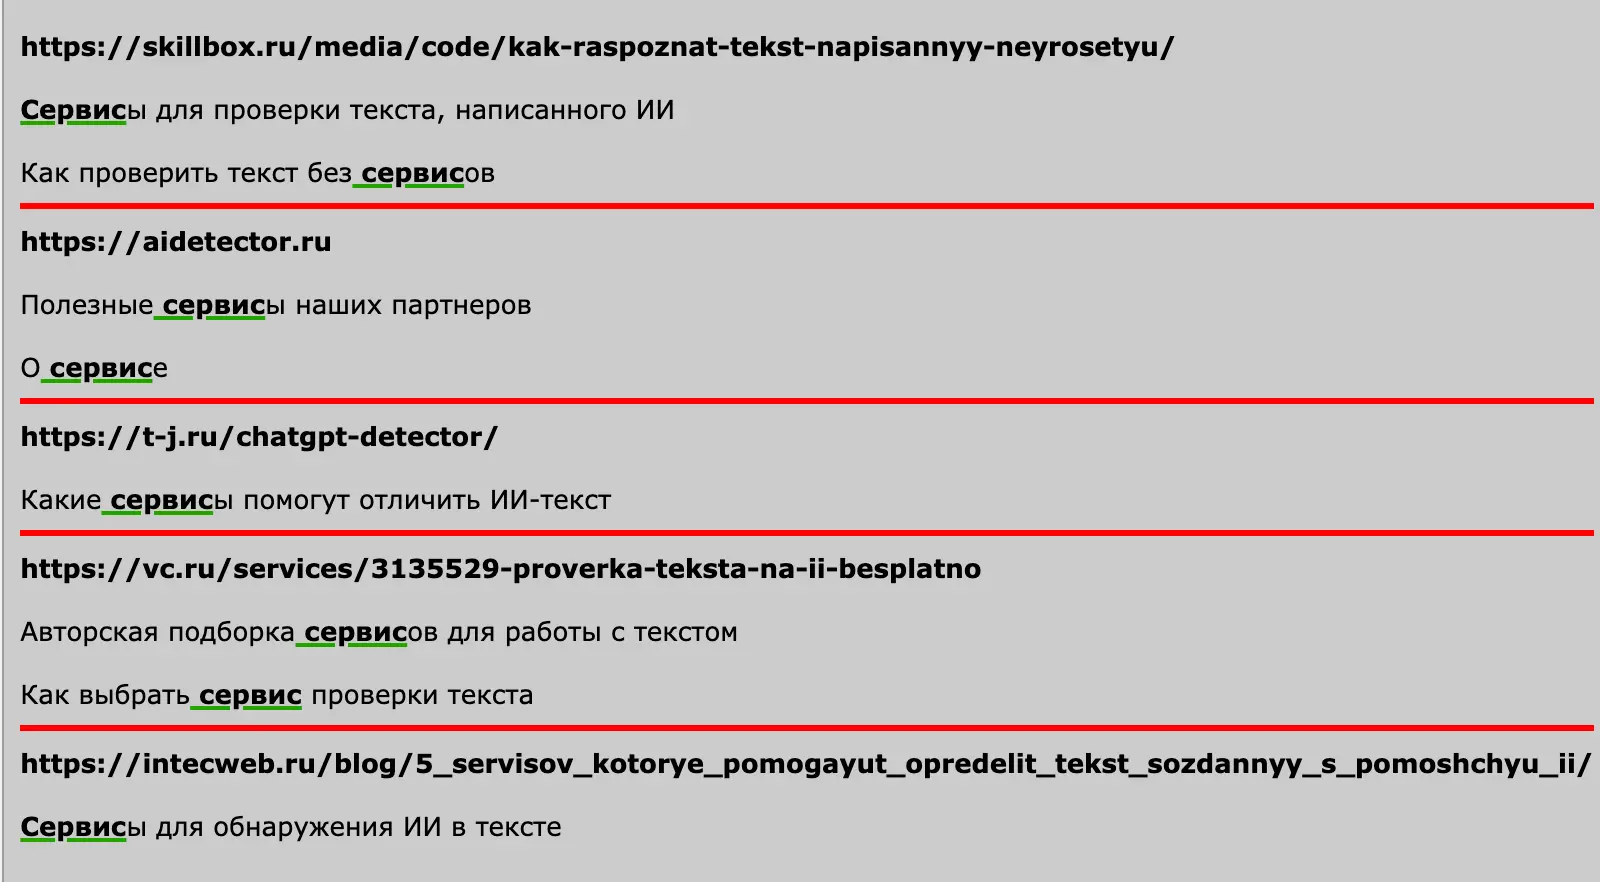
Почему одного частотного списка мало
Корень «сервис» встречается в заголовках про контроль, обнаружение ИИ и подбор инструментов. Без окружения непонятно, нужен ли обзор платформ или объяснение ограничений. Найденные пассажи снимают эту неоднозначность.
В моём разборе такой блок нужен, но его задача уже другой формы. Я сравниваю автоматические сигналы и объясняю, почему машинный вердикт нельзя принимать за доказательство авторства.
Как превратить H1–H6 в план, а не копию топа
Сначала я объединяю словоформы по леммам, затем смотрю число независимых сайтов. После этого открываю пассажи и оставляю сюжеты, соответствующие целевому запросу. Собственные данные про fan-out становятся добавочной ценностью сверх консенсуса.
Если одинаковая лемма встречается в четырёх релевантных H2, то сверьте смысл за каждым заголовком. Итогом станет обоснованный раздел, а не четвёртая копия чужой фразы.
Пошаговый аудит черновика перед размещением
Рабочий порядок важнее набора отдельных метрик. Я двигаюсь от запроса пользователя к фактам, структуре и только потом к формулировкам. Иначе можно идеально отредактировать черновик, который отвечает не на тот вопрос.
- Зафиксируйте намерение. Сформулируйте, что человек должен понять или сделать после чтения. Отделите редактуру от распознавания ИИ, плагиата и технического аудита.
- Посмотрите fan-out. Сохраните дополнительные запросы ассистента, найденные страницы и смысл каждого ответвления. Закройте обязательные ветки в плане.
- Соберите релевантный топ. Не смешивайте обзоры, лендинги, каталоги и площадки распознавания. Сравнивайте URL одной цели.
- Разберите H1–H6. Посчитайте общие основы, n-граммы и уникальные сущности. Затем откройте окружение спорных элементов.
- Проведите фактчек. Сверьте числа, даты, названия функций, цитаты и адреса. Неподтверждённые детали удалите или ослабьте формулировку.
- Добавьте опыт. Вставьте скрин, наблюдение, ограничение метода или результат собственного теста. Такой блок нельзя получить простым пересказом топа.
- Перечитайте вручную. Уберите нейроштампы, одинаковые начала, симметричные списки и выводы без нового смысла.
- Оцените работу целиком. Сопоставьте Title, Description, H1, ссылки и иллюстрации с итоговой версией, а не со старым черновиком.
Если выборка смешивает разные цели, то частотные леммы дадут ложный план. Разделите выдачу по типу и получите пригодную базу для редакторского задания.
Если самостоятельно отделить интенты, выбрать конкурентов и определить допустимые диапазоны сложно, можно заказать семантический аудит материала с готовым перечнем правок.
Сервисы для аудита текста
Инструменты отвечают на разные вопросы. AI-анализатор оценивает статистическую похожесть на машинное письмо. Сверка уникальности ищет совпадения, редактор подсвечивает языковой шум, а поисковый модуль сравнивает черновик с выдачей.
Если нужно подобрать решение именно для поисковой оптимизации, посмотрите моё сравнение анализаторов контента: там платформы разделены по метрикам и сценариям применения.
| Инструмент | Рабочий сигнал | Чего не доказывает |
|---|---|---|
| AI-детектор | Подозрительно предсказуемые участки | Кто создал образец |
| Антиплагиат | Близкие или скопированные формулировки | Ценность и достоверность |
| Редакторский анализ | Штампы, перегруженность и слабый синтаксис | Соответствие поисковому намерению |
| Сравнение с выдачей | Пропущенные аспекты, слова и зоны | Будущую позицию в поиске |
У таких анализаторов бывают ложные срабатывания на человеческих работах и разные оценки одного отрывка. Поэтому процент служит поводом перечитать участок. Он не заменяет черновики, историю правок и редакторское решение.
Для русского языка сначала сверьте ограничения конкретной платформы, допустимый объём и политику хранения данных. Не загружайте клиентские файлы с персональной или закрытой информацией в неизвестный сервис.
Как доработать черновик после ChatGPT
Сырая версия часто звучит гладко, но не даёт отрицательного знания. В ней описан правильный путь, однако нет границ метода, неудачных сценариев и причин ошибки. Именно здесь нужен человек с практикой.
Уберите нейроштампы и одинаковый ритм
Найдите обороты «в современном мире», «играет ключевую роль» и «не просто, а». Посмотрите, не начинаются ли соседние абзацы одинаково. Меняйте не отдельные синонимы, а функцию блока: тезис, пример, ограничение или действие.
Добавьте авторскую фактуру
Здесь фактурой служат экспорт fan-out, частота лемм H2 и выдержки конкурентов. Скрины показывают процесс, а не украшают страницу. Читатель может повторить логику на своём проекте.
Верните правки нейросети небольшими порциями
Передайте модели начальный абзац, замечание и желаемый результат. Просите сохранить подтверждённые факты и не добавлять новые числа. После ответа сравните версии вручную.
Если отдать на переписывание весь результат без ограничений, то модель может вернуть старые штампы и новые галлюцинации. Локальная правка сохраняет достоверные части и сокращает повторный фактчек.
Когда мой парсер ускоряет ручной сбор
H1–H6 нескольких URL можно собрать вручную или простым скриптом. Сложность начинается, когда нужны леммы по уровням, уникальные элементы, дубли и выдержки из окружения. Именно такой набор я сделал для собственной работы.
В текущей публичной выборке я не нашёл решения, которое показывает все нужные мне слои в одном отчёте. Это не доказательство отсутствия аналогов на всём рынке. Зато мой инструмент уже отдаёт данные в формате, пригодном для передачи нейросети.
В отдельном разборе я сравнил аналоги ГАР ПРО для анализа контента: частотные метрики, нейросетевые методы, скорость и условия использования разных сервисов.
Кому подходит такой анализ
- специалисту по продвижению, который собирает план по одному кластеру;
- редактору, которому нужны аспекты и примеры употребления;
- владельцу сайта, оценивающему полноту готового контента.
Кому он не заменит работу
- автору без собственной фактуры и доступа к данным;
- проекту с техническими проблемами индексации;
- команде, которая ждёт гарантии топа от одного текстового фактора.
Парсер можно потестировать пару дней бесплатно. Затем полный доступ стоит 1 000 рублей в месяц. Он помогает собрать данные, но финальное решение по структуре и формулировкам остаётся за специалистом.
Частые вопросы об аудите перед размещением
- Google запрещает материалы, созданные генеративным ИИ?
- Нет общего запрета по способу создания. Google просит оценивать точность, качество, релевантность и ценность. Массовая генерация URL без добавленной пользы может нарушать политику о масштабированном злоупотреблении контентом.
- Можно ли доверять проценту AI-детектора?
- Считайте его сигналом для ручной вычитки. Один процент не подтверждает авторство и не измеряет полноту, фактическую точность или поисковое намерение.
- Нужно ли копировать H2 конкурентов?
- Нет. Соберите общие сюжеты и основы слов, изучите исходные фрагменты, затем сформулируйте собственную архитектуру. Заголовок должен обещать реальное содержание блока.
- Что передавать нейросети кроме ключевых слов?
- Добавьте цель документа, типы конкурентов, H1–H6, окружение терминов, подтверждённые ссылки и ограничения. Такой набор снижает число догадок при генерации.
- Гарантирует ли проработанная структура рост позиций?
- Нет. Она помогает поиску и читателю понять материал, но результат зависит от намерения, качества ответа, технического состояния, ссылок и других факторов.
- Как понять, что работа закончена?
- Читатель получает полный ответ без нового обращения к выдаче, факты подтверждены, а каждый раздел выполняет отдельную задачу. Мета-теги и ссылки должны соответствовать финальной редакции.
Мой вывод пока такой: чатгпт хорошо ускоряет сборку, когда получает нормальные исходники. Аудит начинается не с вопроса «спалит ли алгоритм», а с намерения, данных и структуры. Fan-out показывает дополнительные ветки, основы H1–H6 — общий каркас, а исходные фрагменты защищают от механического списка слов.



Есть вопрос или свой опыт?
Дополните материал своим примером или задайте вопрос. Комментарии загрузятся только после нажатия.