
Как выбрать конкурентов для текстового анализа
Я начинаю не с десятки лидеров одной выдачи. Беру 50–100 разных поисковых запросов внутри одного кластера, снимаю выдачу для каждой, считаю повторения доменов и открываю найденные адреса. Только устойчивые и подходящие документы отправляю на текстовый анализ. Иначе случайный лидер, агрегатор или инструкция с другим намерением испортят выводы. Ниже разберу весь маршрут на примере ремонта квартир: от семантики до плана собственной посадочной. Покажу порядок решений на каждом этапе.
Почему одного поискового среза мало
Допустим, нужна коммерческая посадочная про ремонт квартир под ключ. Открыть один запрос и скопировать первую десятку легко. Но соседняя формулировка меняет состав выдачи: рядом с подрядчиком оказываются каталог, объявление, инструкция или сильный бренд с огромной структурой. Средняя длина их страниц ничего не скажет о задаче вашей услуги.
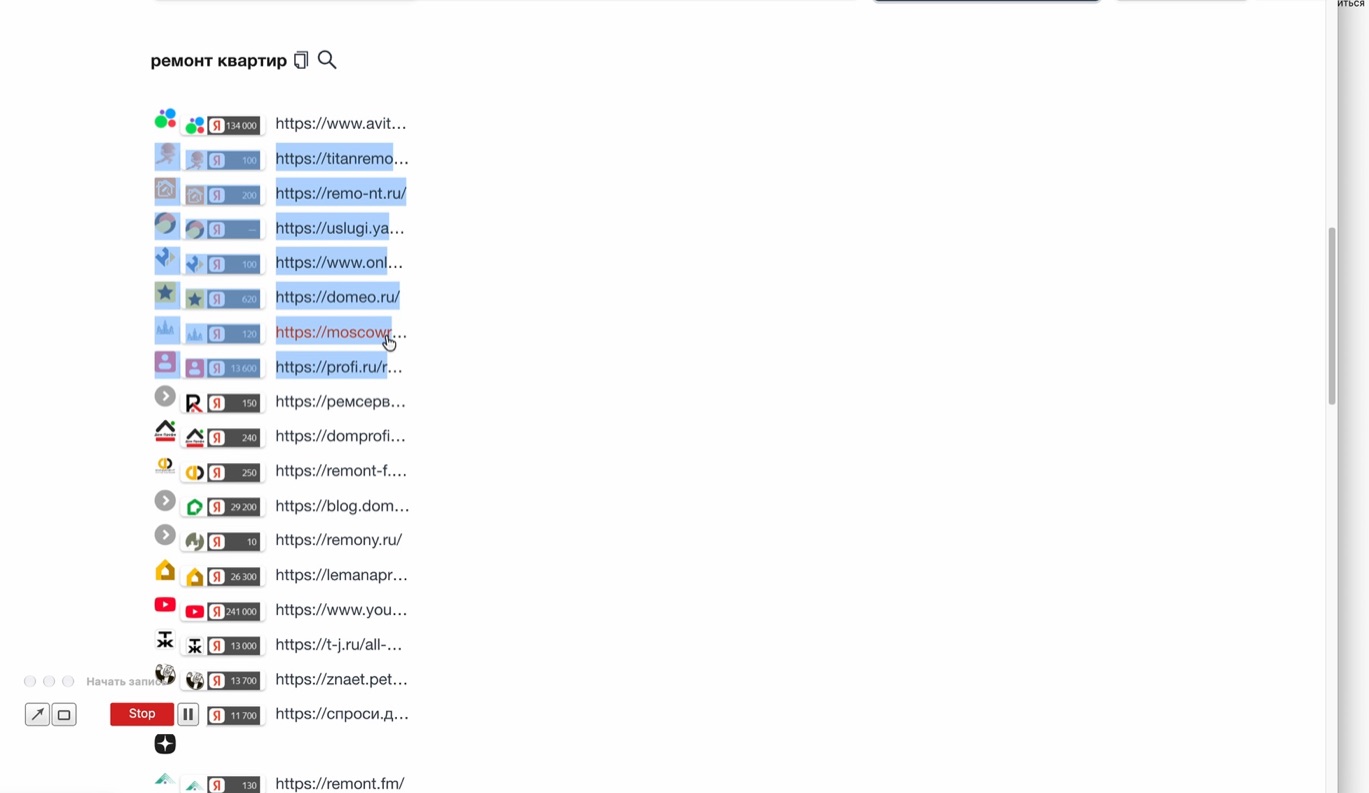
На записи я показываю такой одиночный срез. Он полезен лишь как отправная точка: нельзя заранее знать, кто заметен во всей нише. Поэтому фиксирую не только позиции, но и охват многих формулировок. В геозависимых нишах отмечаю регион; Яндекс объясняет его влияние в справке о региональности.
Соберите 50–100 фраз одной задачи
В ролике для демонстрации я беру около 50 ключей. В полной версии собираю 50–100 разнообразных запросов из одной семантической группы: основное название услуги, цену, формат, условия, город, близкие потребности клиента. Это не перестановки слов ради количества. Если человек ищет инструкцию, а не исполнителя, такая фраза уходит в иной кластер.
Источники — своя семантика, реальные показы, подсказки и видимость профильных проектов. На видео я открываю Мутаген: у remont.fm вижу приблизительно 506 строк и выбираю относящиеся к ремонту под ключ. Остальное добираю вручную из собственных данных и соседних ресурсов. Так возникает рабочая пачка, которую можно снять в одной системе и одном регионе.

Я помечаю намерение человека и географию в таблице. Если посадочная уже опубликована, использую данные Яндекс Вебмастера; справка сервиса показывает, где смотреть статистику. Главный критерий: все выбранные формулировки действительно ведут к одному целевому адресу.
Кого считать соперником в поиске
Бизнес-соперник предлагает похожее решение той же аудитории. Поисковый конкурент — понятие шире: там могут стоять агрегаторы, маркетплейсы, энциклопедии, отзовики и статьи. Каждый занимает место, но их содержимое решает разные задачи. Я разделяю типы до расчёта средних значений и объясняю, как использую каждую группу.
| Тип документа | Роль в сравнении |
|---|---|
| Профильный подрядчик | Образец конкурента: предложение, условия и структура |
| Каталог или маркетплейс | Отдельно изучаю фильтры, ассортимент, навигацию |
| Информационная статья | Беру вопросы аудитории, исключаю из коммерческого среднего |
| Другой город | Отмечаю идеи, не переношу чужие цены и адреса |
Такой разбор позволяет выбрать конкурентов для текстового анализа без смешения несовместимых форматов. Если выдача почти целиком состоит из площадок, я фиксирую это свойство ниши и ищу профильных исполнителей глубже.
Снимите выдачу всей пачки
В скринкасте я использую PR-CY: сервис ставит списки нескольких ключей рядом. В Яндексе просматриваю первые двадцать позиций. Ниже первой десятки нередко видны более близкие подрядчики, тогда как наверху стоят крупные универсальные домены.
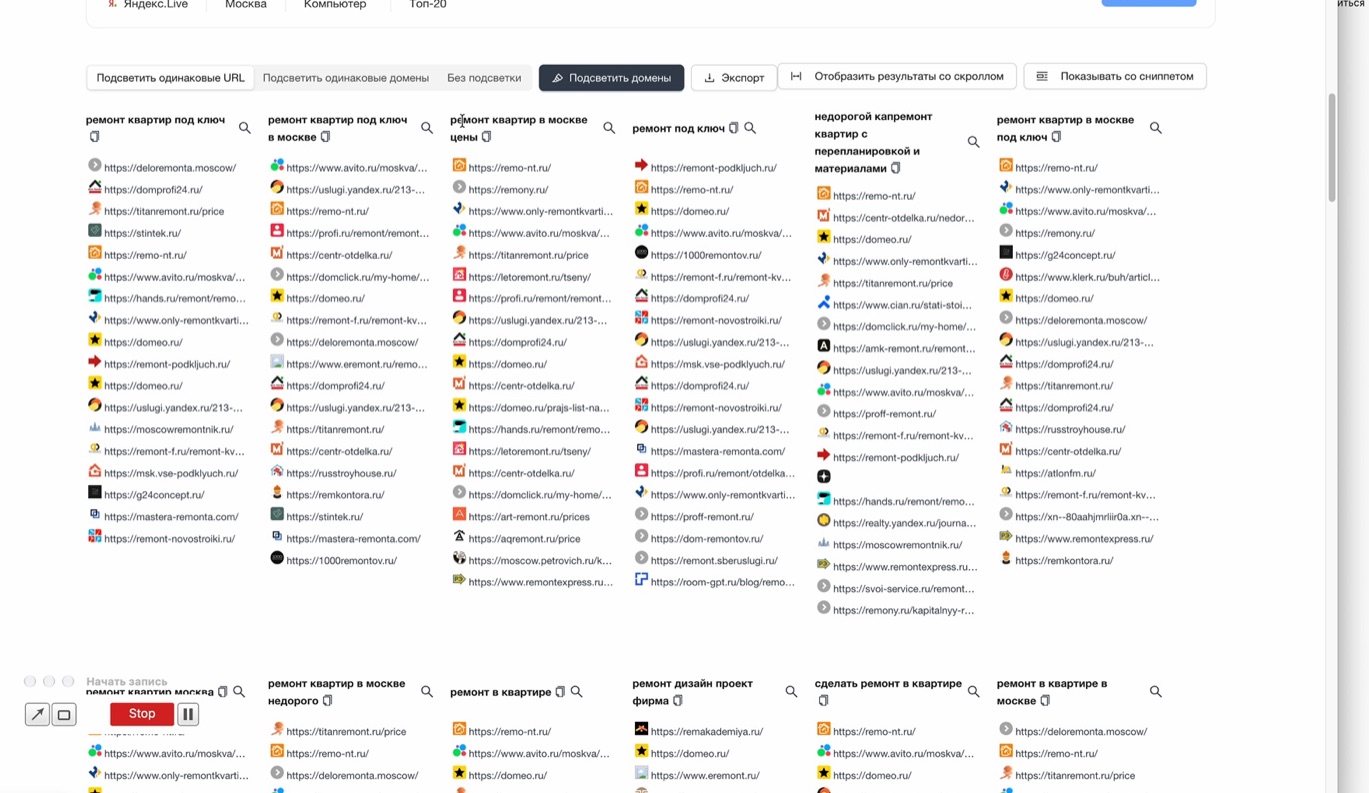
Дальше считаю повторения доменов и отдельных URL. На записи один проект встречается в результатах 46 фраз. Это сильный кандидат, но ещё не готовый образец: нужно открыть URL, сопоставить интент, географию и предложение. Если в отчёт попала главная, а услуга раскрыта на внутренней посадочной, беру её адрес.
Удобная таблица содержит пять граф: запрос, регион, позиция, домен, URL. Потом добавляю тип документа и причину включения. Такой формат сразу показывает охват семантики и не даёт принять известный бренд за доказательство релевантности отдельного документа.
Что оценить у кандидата до парсинга
Перед текстовым анализом я сравниваю интент, тип посадочной, регион и сам продукт. Смотрю первый экран, оффер, ассортимент, цены, порядок заявки, примеры выполненных проектов и работу с возражениями. У крупного каталога иной масштаб, поэтому его объём нельзя автоматически переносить на лендинг одной компании.
Широкое исследование рынка может включать трафик, ссылки, возраст домена, рекламу и соцсети. Редактору сначала важнее другое: условия предложения, доказательства опыта и неразобранные вопросы клиента. По итогам записываю конкретное действие для собственного лендинга.
Стоп-лист и объём рабочей выборки
Я исключаю документы с другим намерением: инструкцию вместо услуги, вакансию, витальный документ, страницу отзывов, карточку товара, общую главную при наличии нужной внутренней посадочной. Региональные различия отмечаю отдельно. Предположение о накрутке не делаю основанием для автоматического удаления URL; сначала открываю его и оцениваю содержимое.
В AI-ответах встречаются советы начать с 3–7 релевантных лидеров либо изучить 5–7 организаций и 10–15 публикаций. Это быстрый обзор. Мой отбор опирается на пересечение позиций всей семантики: в демонстрации после ручной фильтрации осталось около 23 URL. Число не назначаю заранее; если тема слишком широка, разбиваю её на соседние группы.
Причину исключения конкурента записываю коротко: «чужой город», «не та услуга», «каталог», «информационная статья», «парсер забрал меню». Тогда решение можно повторить и обсудить без догадок.
Убедитесь, что инструмент прочитал нужное
Очищенную выборку загружаю в свой парсер. На записи он помечает подозрительно короткое содержимое и чересчур длинные публикации. Пустая выгрузка бывает из-за защиты или ошибки извлечения; огромный объём часто означает каталог с карточками. Открываю проблемный URL и сверяю выгрузку с видимой частью. Иногда достаточно заменить адрес внутренним разделом, иногда источник исключаю.
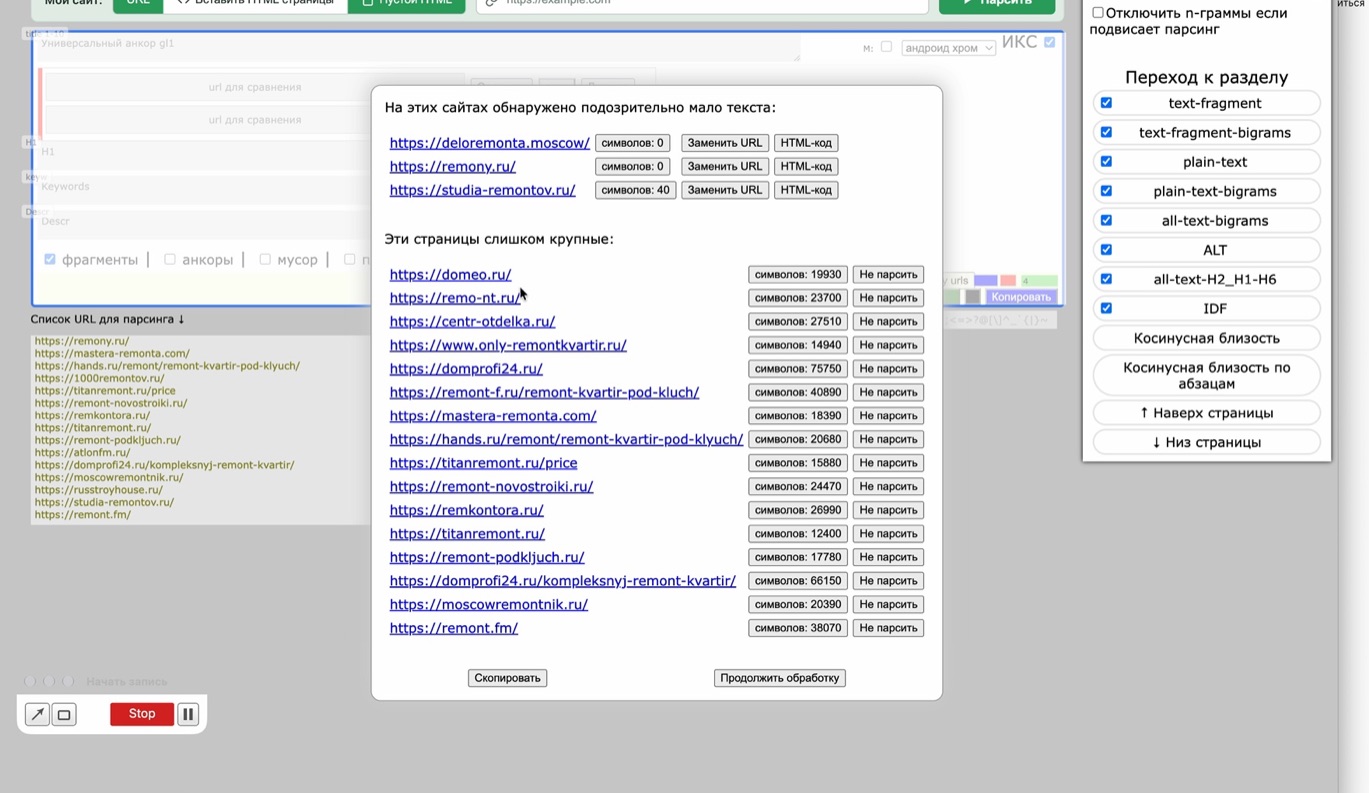
Это обязательная подготовка к текстовому анализу: неверно извлечённые меню и футеры портят даже правильно собранную выборку. Очищенный набор передаю дальше без попытки компенсировать ошибку дополнительными ключевыми словами.
Текстовые данные: слова, фрагменты, анкоры
Затем парсер собирает лексику, словосочетания, фрагменты с соседним контекстом, подписи ссылок и заголовки. Одно слово подсказывает тему, фрагмент раскрывает смысл, анкор показывает навигационную роль. Эти данные нельзя складывать в один список «вставить в абзац».
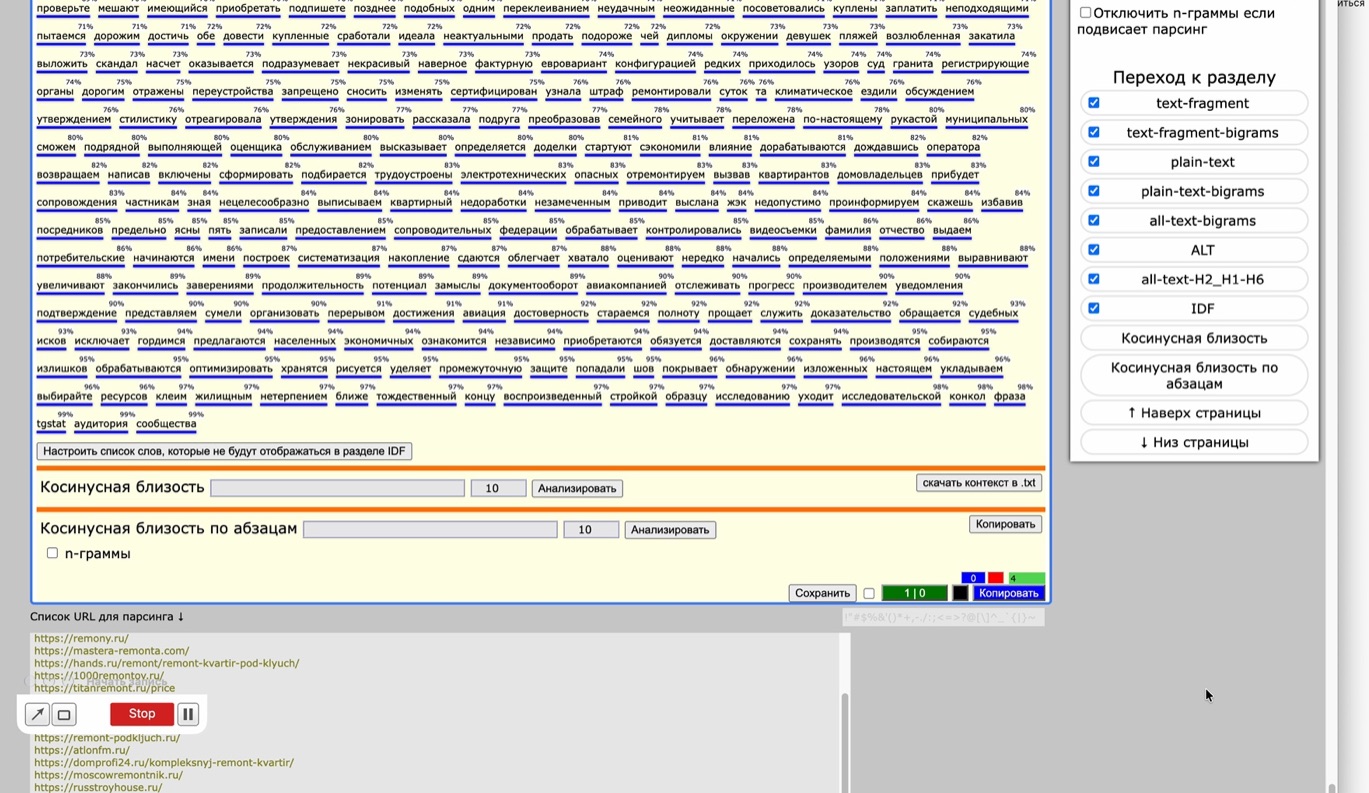
В моей выгрузке однословных анкоров из 18 проектов видны повторяемость и положение элементов в меню. Но «блог» или мусорное «nbsp» не становятся обязательным разделом. Когда встречаются «смета», «материалы», «этапы», «стоимость», я решаю, где показать настоящую смету и объяснить условия. Ширина релевантных смыслов, встроенных в полезный текст, в моей практике помогает росту в Яндексе и Google.
Разберите полную структуру H1–H6
Вектор заголовков — отдельный приоритет. Я смотрю, как другие проекты раскрывают процесс, цены, условия, доказательства опыта и частые вопросы; отмечаю уровни H2–H3 и вложенные разделы. Особенно внимательно делаю это для Google. Затем строю собственную иерархию под реальный продукт, не копируя чужие формулировки.
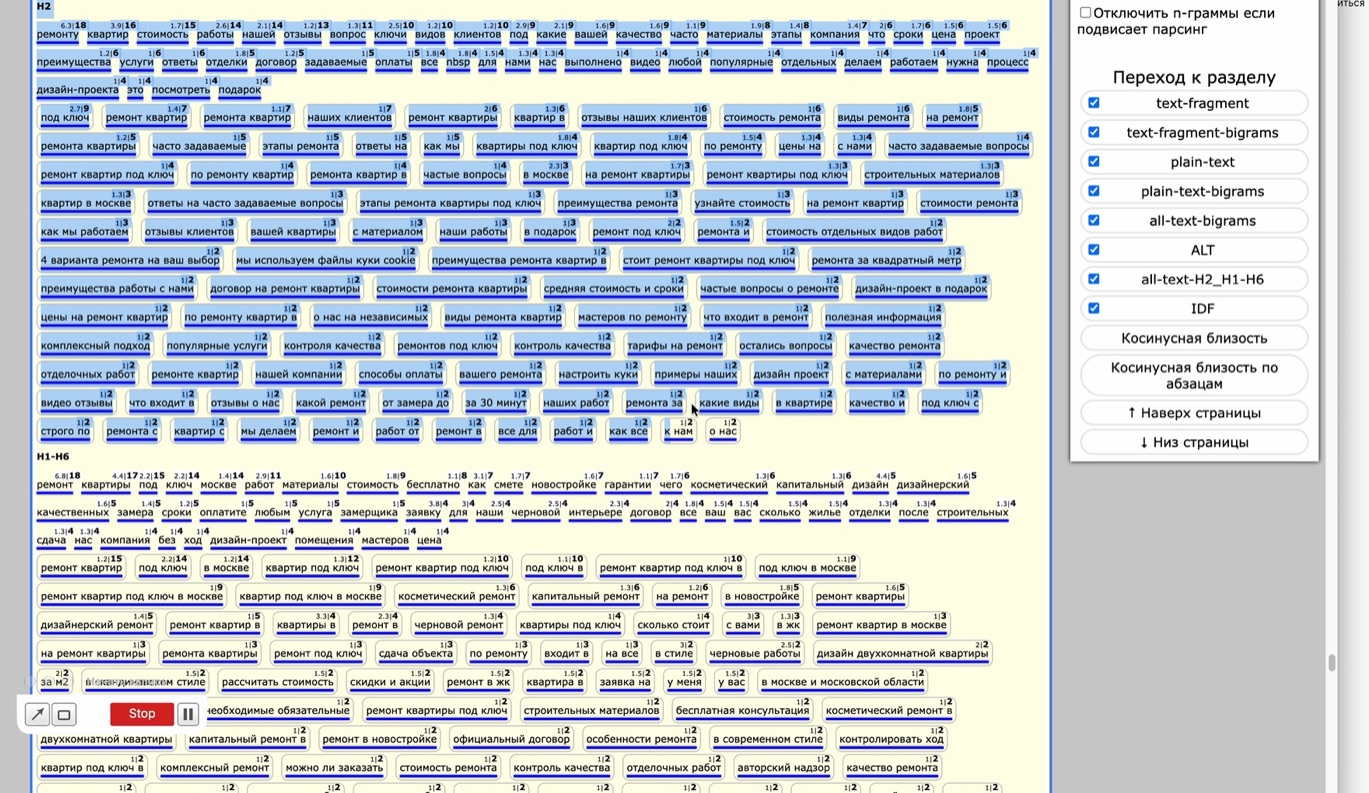
- Объединяю одинаковые сюжеты из разных документов.
- Сверяю их с намерением своего кластера.
- Под каждый важный раздел подбираю факт, пример или иллюстрацию.
- Развожу суть предложения, этапы, условия и FAQ.
Заголовок нужен там, где за ним стоит содержательное объяснение. При ремонте квартир это могут быть виды задач, смета, комплектующие, сроки и порядок приёмки. Такая схема расширяет полезное содержание без механического набивания слов.
Что добавить из AI-обзоров
AI-обзоры и веер смежных вопросов помогают увидеть пропуски: критерии отбора, стоп-лист, глубину просмотра, регион, инструменты, разницу Яндекса и Google. Я сверяю их с планом и добавляю только то, что относится к предложению. На этапе текстового анализа совет взять несколько лидеров из одной выдачи использую как начальную проверку, а не как замену матрицы из всей семантики.
Если доступен реальный AI Overview, записываю дату, географию, формулировку и упомянутые источники. Сопоставляю их вопросы с собственным содержанием. Соседний вопрос без связи с услугой не включаю ради видимости полноты.
Google: ручной просмотр разных городов
В конце видео я показываю дополнительный приём. Сторонние съёмы Google у меня нередко расходятся с обычной выдачей, поэтому важные запросы открываю руками. В некоторых проектах беру 10–20 городов. Москва, Петербург и другие гео дают новые образцы структуры, которых не видно в одном локальном срезе.
Чужие контакты и цены остаются местными деталями. Меня интересуют повторяющиеся потребности, логика H1–H6 и способ объяснить этапы. По моим наблюдениям, широкая предметная структура даёт Google больше точек входа в нишу.
Маршрут из скринкаста: ремонт квартир
- Определяю коммерческий кластер и выбираю около 50 фраз; в полном проекте расширяю набор до 50–100.
- В Мутагене изучаю семантику remont.fm: из приблизительно 506 строк беру подходящие.
- В PR-CY снимаю первые двадцать позиций, считаю повторения доменов и URL.
- Открываю лидера, заметного по 46 фразам, затем отсеиваю чужой формат и регион.
- После отбора конкурентов остаётся около 23 адресов; загружаю их в парсер.
- Разбираю фрагменты, анкоры и заголовки. На этой основе пишу план собственной посадочной.
Парсер ускоряет обработку, но выбор источников сделан раньше. В этом суть моего метода: сначала широкий срез спроса, затем осмысленная выборка и только потом цифры отчёта.
Контроль перед написанием
- Один ключ. Случайный состав лидеров принимают за весь спрос.
- Разный интент. Подрядчика усредняют с инструкцией или каталогом.
- Известный домен. Бренд выбирают без оценки конкретного URL.
- Грязная выгрузка. Меню и карточки принимают за основное содержимое.
- Слепое копирование. Частоты и H2 переносят без пользы читателю.
- Чужая география. Локальные цены превращают в общий шаблон.
Перед редактурой у меня должны быть: одна группа намерений, регион, матрица выдачи, причины исключений, корректно извлечённые фрагменты и отдельная схема заголовков. После публикации оцениваю реальные показы и дорабатываю недостающие темы.
Короткие ответы
Почему именно 50–100?
Это мой рабочий диапазон в широкой нише. В узкой нише беру меньше, если релевантных вариантов просто нет. Широкий кластер делю на несколько близких кластеров.
Брать всю первую двадцатку?
Нет. Топ-20 — глубина поиска кандидатов. В выборку попадают лишь документы с одинаковым намерением и форматом.
Нужен весь ресурс целиком?
При разборе одной посадочной важен конкретный адрес. Весь ресурс изучаю, когда проектирую разделы или оцениваю ассортимент.
Что важнее: слова или заголовки?
Оба слоя. Фрагменты дают смысл и лексику; H1–H6 показывают самостоятельные разделы. Вместе они помогают написать содержательную статью.
Можно отправить выгрузку в нейросеть?
Да, после очистки. Передаю семантику, фрагменты, анкоры, схему H1–H6 и собственные факты. Иначе модель может принять чужое меню за часть задания.

Есть вопрос или свой опыт?
Дополните материал своим примером или задайте вопрос. Комментарии загрузятся только после нажатия.